第24回 言語聴覚士国家試験 午前 第29問 | 分野:心理測定法
「標本の大きさ」は、身長や得点の大きさのことではありません。この記事では、標本の大きさ=何人分のデータかを、母集団と標本の図で説明します。
問題
サンプリング(標本抽出)とサンプル(標本)に関する記述として誤っているのはどれか。
- 1.標本の大きさは標本の値によって算出される。
- 2.標本集団の統計量によって母集団を推定する。
- 3.標本調査は全数調査よりも費用の節約になる。
- 4.部分集団ごとにランダムサンプリングを行う方法を層別抽出法という。
- 5.推測統計はランダムサンプリングの原理に基づいている。
まずは自分で答えを選んでから、下のボタンを押して正答を確かめてください。
▶ ここを押して正答を見る
正答:1(標本の大きさは標本に含まれるデータの個数で、値から計算するものではない)
この問題で問われていること
標本調査と推測統計の基本が問われています。
この問題で間違えやすい理由
① 「標本の大きさ」を、測った値の大きさと思いやすい。
② 層別抽出や推測統計など、言葉が多い。
まずは基本:母集団と標本
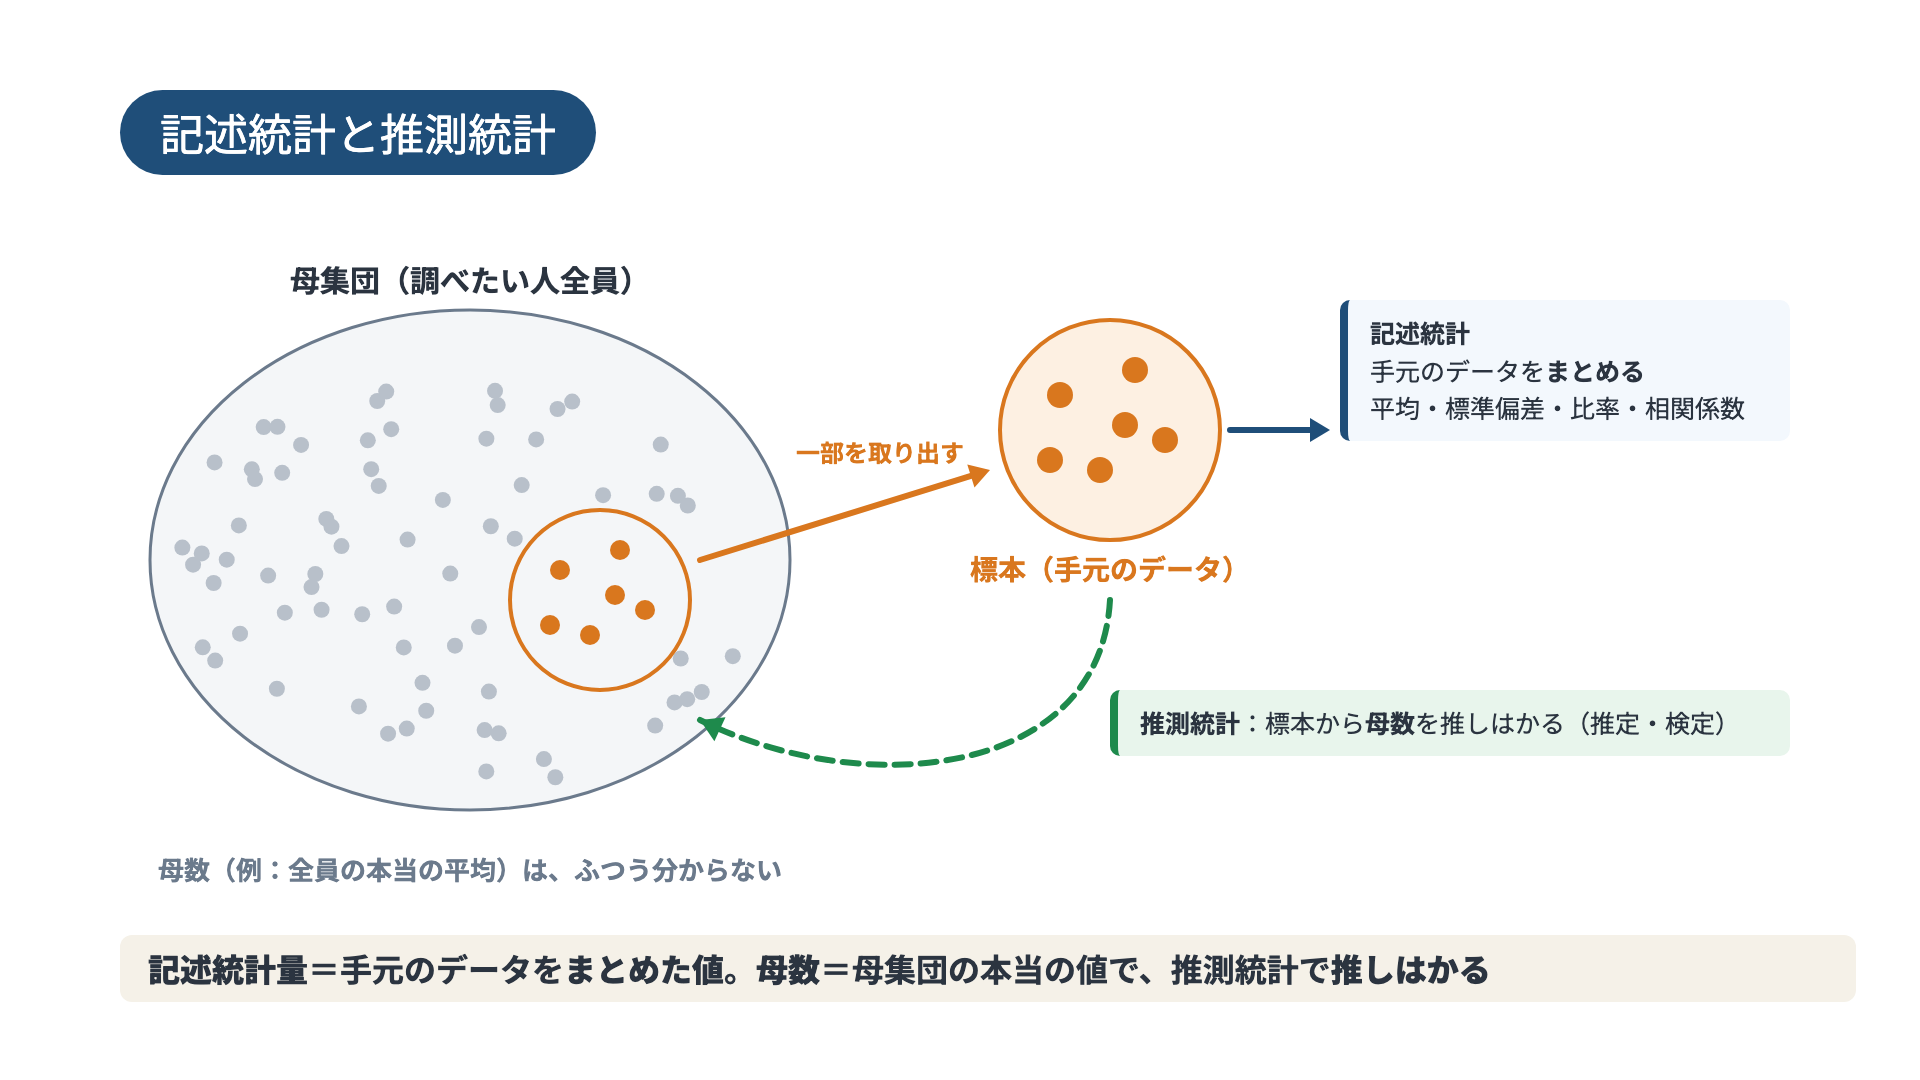
母集団は、調べたい人全員です。標本(サンプル)は、そこから選んで実際に調べる一部の人です。標本を選ぶことを標本抽出(サンプリング)といいます。
標本の大きさは、標本に何人分(何個分)のデータが入っているかです。記号nで表します。「大きさ」という言葉に引っぱられて、測った値の大きさと混ぜないようにします。
4つの抽出法
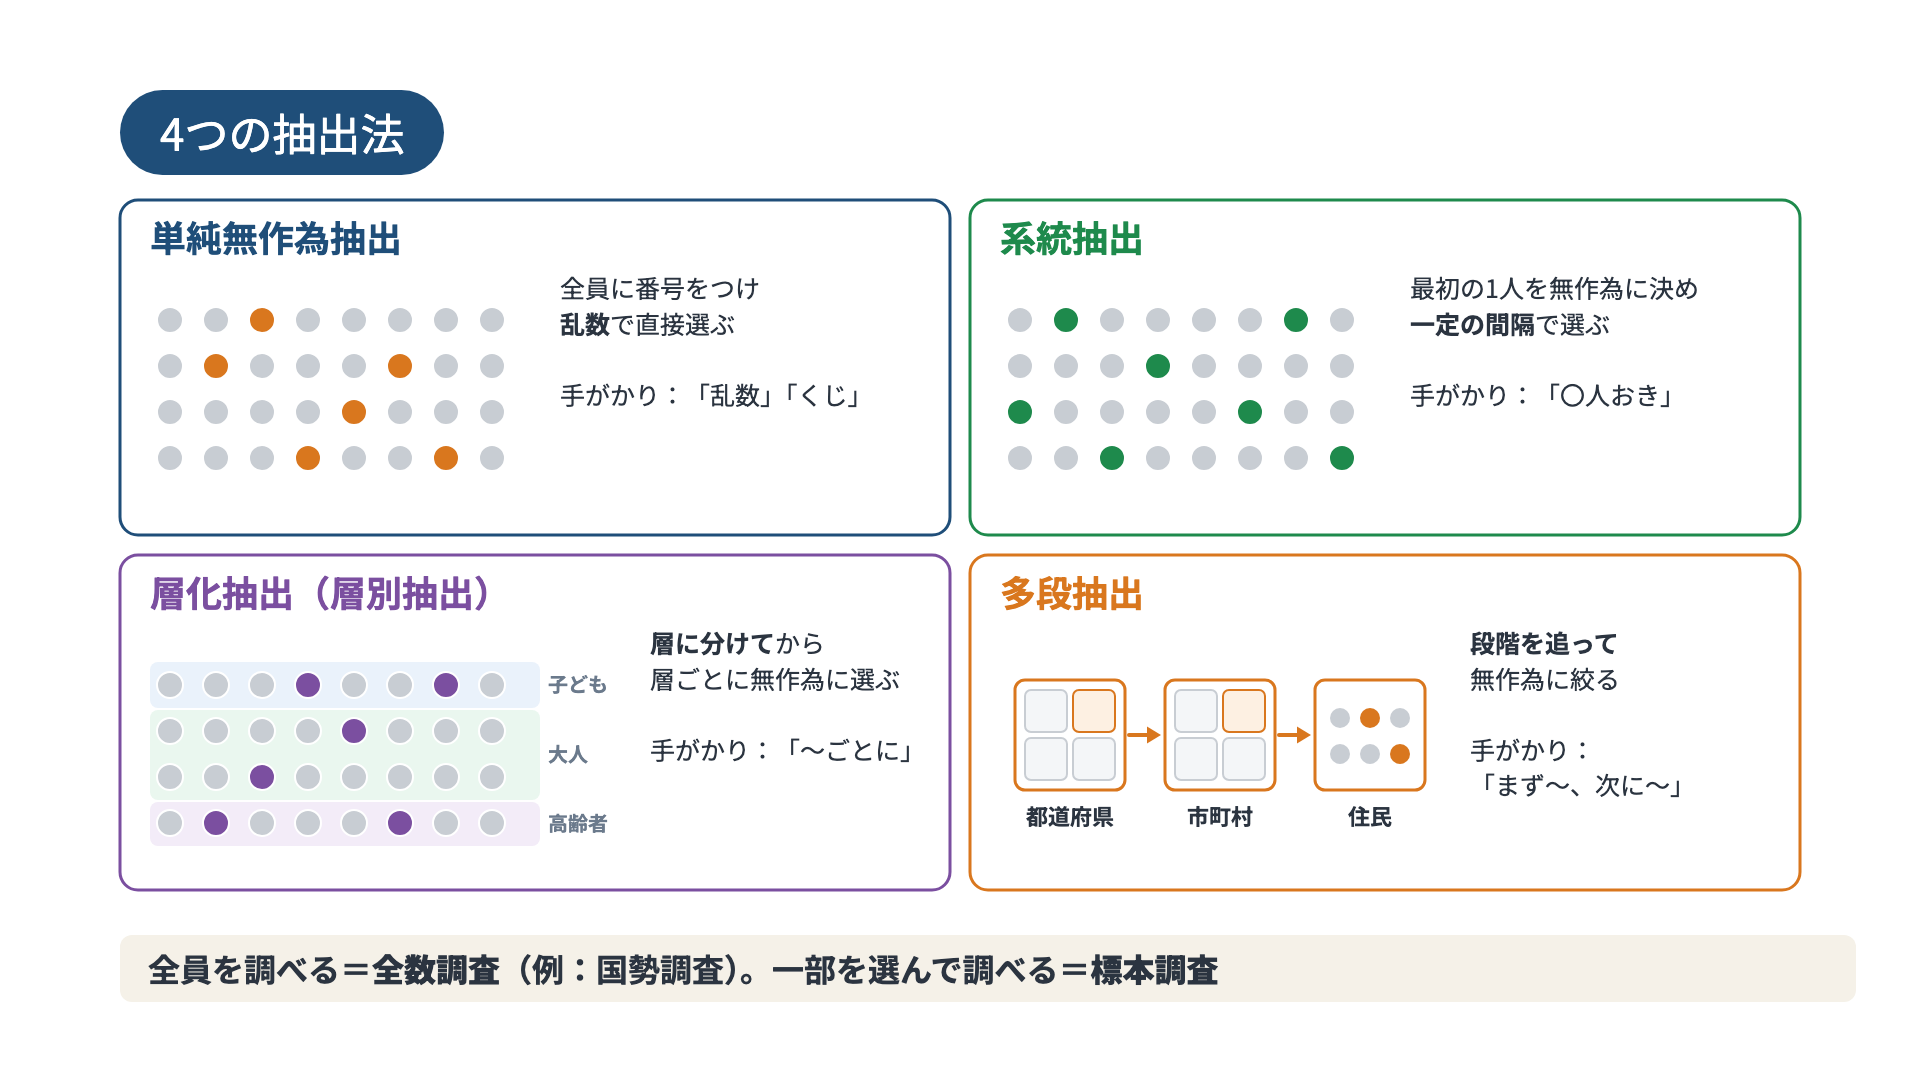
「部分集団ごとに」は、層化抽出(層別抽出)の手がかりの言葉です。
選択肢ごとの解説
1.標本の大きさは標本の値によって算出される。
× 誤り
標本の大きさ(n)は、標本に含まれるデータの個数(人数)です。測った値がどうであっても変わりません。誤っているので、これが正答です。
何人集めるかは、調査の前に、求める精度などから決めておきます。
2.標本集団の統計量によって母集団を推定する。
〇 正しい
標本の平均や割合をもとに、母集団の値を推しはかるのが推測統計です。正しい文です。
3.標本調査は全数調査よりも費用の節約になる。
〇 正しい
一部だけを調べるので、費用・時間・人手が少なくて済みます。正しい文です。
そのかわり、標本と母集団の値のずれ(標本誤差)が生じます。
4.部分集団ごとにランダムサンプリングを行う方法を層別抽出法という。
〇 正しい
性別や年齢などの層に分けて、層ごとに無作為に選ぶのが層別抽出法(層化抽出法)です。正しい文です。
5.推測統計はランダムサンプリングの原理に基づいている。
〇 正しい
推測統計は、標本が無作為に選ばれていることを前提に、確率を使って母集団を推しはかります。正しい文です。
以上から、正答は1です。
言語聴覚士の臨床とつなげる
研究論文の「n=30」は、30人分のデータという意味です。nが小さいと、標本の結果が偶然に左右されやすくなります。結果を読むときは、何人を、どのように選んだのかを確かめます。
覚え方
標本の大きさ=人数(n)。値の大きさではない。
標本の統計量から母集団を推定=推測統計。
確認問題(一問一答)
Q1. 標本の大きさとは?
答えを見る
標本に含まれるデータの個数(人数)。
Q2. 標本から母集団を推しはかるのは?
答えを見る
推測統計。
Q3. 層ごとに無作為に選ぶ方法は?
答えを見る
層別抽出法(層化抽出法)。
Q4. 標本調査の利点は?
答えを見る
費用・時間・人手が少なくて済む。
Q5. 推測統計が前提にしている選び方は?
答えを見る
ランダムサンプリング(無作為抽出)。
まとめ
- 標本の大きさは、データの個数(人数)。
- 標本の統計量から母集団を推定するのが推測統計で、無作為抽出が前提。
- 正答は1。
次に復習すること
- 4つの抽出法
- 無作為抽出でできること
- 記述統計と推測統計
出典
問題文:第24回 言語聴覚士国家試験 午前 第29問