第26回 言語聴覚士国家試験 午後 第27問 | 分野:心理測定法
無作為に選べば、偏りはすべてなくなる。そう思っていると間違える問題です。この記事では、「だれを調べるか」と「どの群に入れるか」を分けて考えます。
問題
母集団からランダムサンプリング(無作為抽出)を行うことで可能になるものとして誤っているのはどれか。
- 1.確率的な検討
- 2.限られた標本から得られた結果の一般化
- 3.剰余変数の影響の除去
- 4.調査に要する労力の抑制
- 5.標本誤差の評価
まずは自分で答えを選んでから、下のボタンを押して正答を確かめてください。
▶ ここを押して正答を見る
正答:3(剰余変数の影響は、条件をそろえる・無作為割付で抑えるもので、無作為抽出では除けない)
この問題で問われていること
無作為抽出で何ができるようになるかが問われています。
この問題で間違えやすい理由
① 「無作為なら偏りがなくなる」と、何でもできる気がしてしまう。
② 剰余変数という言葉になじみがない。
まずは基本:4つの抽出法
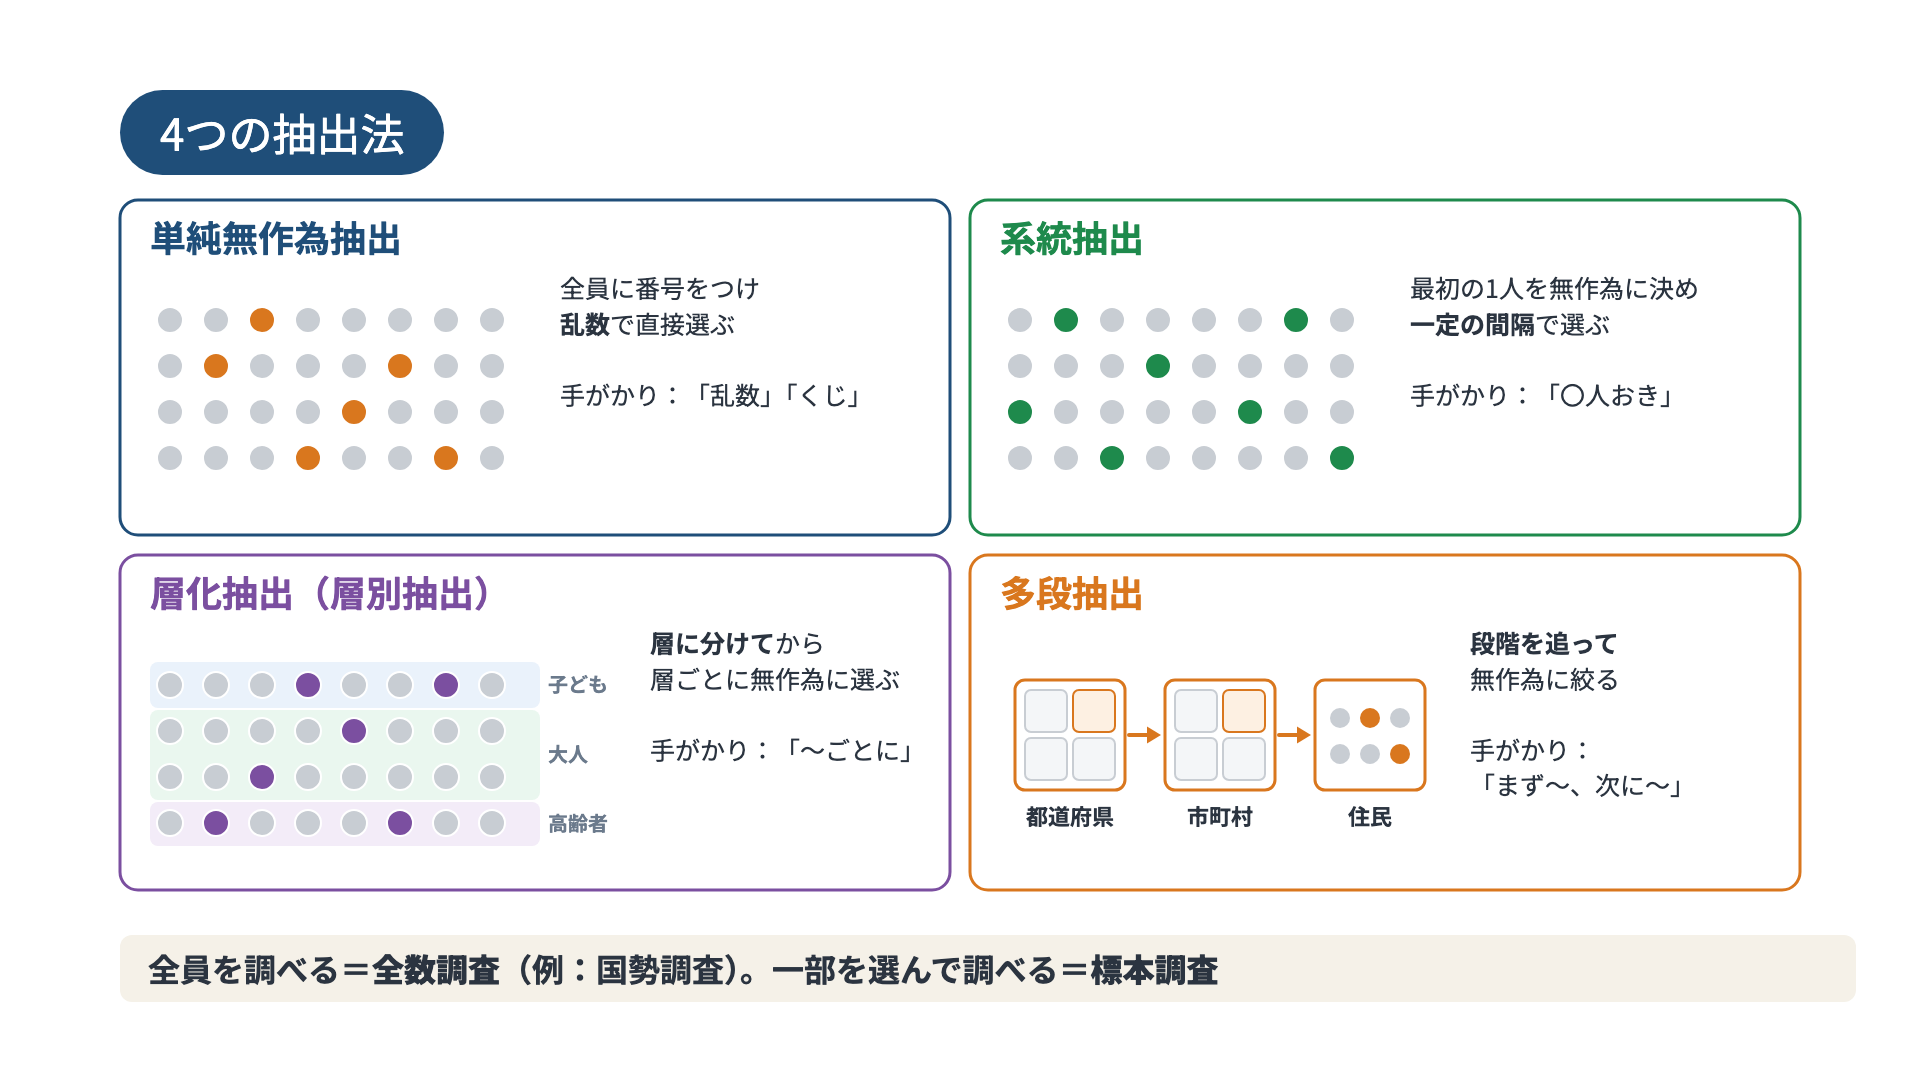
母集団は、調べたい人全員です。標本(サンプル)は、そこから選んで実際に調べる一部の人です。標本を選ぶことを標本抽出(サンプリング)といいます。
無作為は「わざと選ばない」という意味です。くじや乱数のように、だれが選ばれるかを偶然に任せます。こうすると、だれもが同じ確率で選ばれます。
単純無作為抽出の「単純」は、「特別な工夫をしない」という意味です。層に分ける(層化抽出)、段階を追う(多段抽出)、一定の間隔で選ぶ(系統抽出)といった工夫をせず、全員の中から、くじや乱数でそのまま選びます。4つの抽出法のうち、いちばん基本の形です。
剰余変数とは
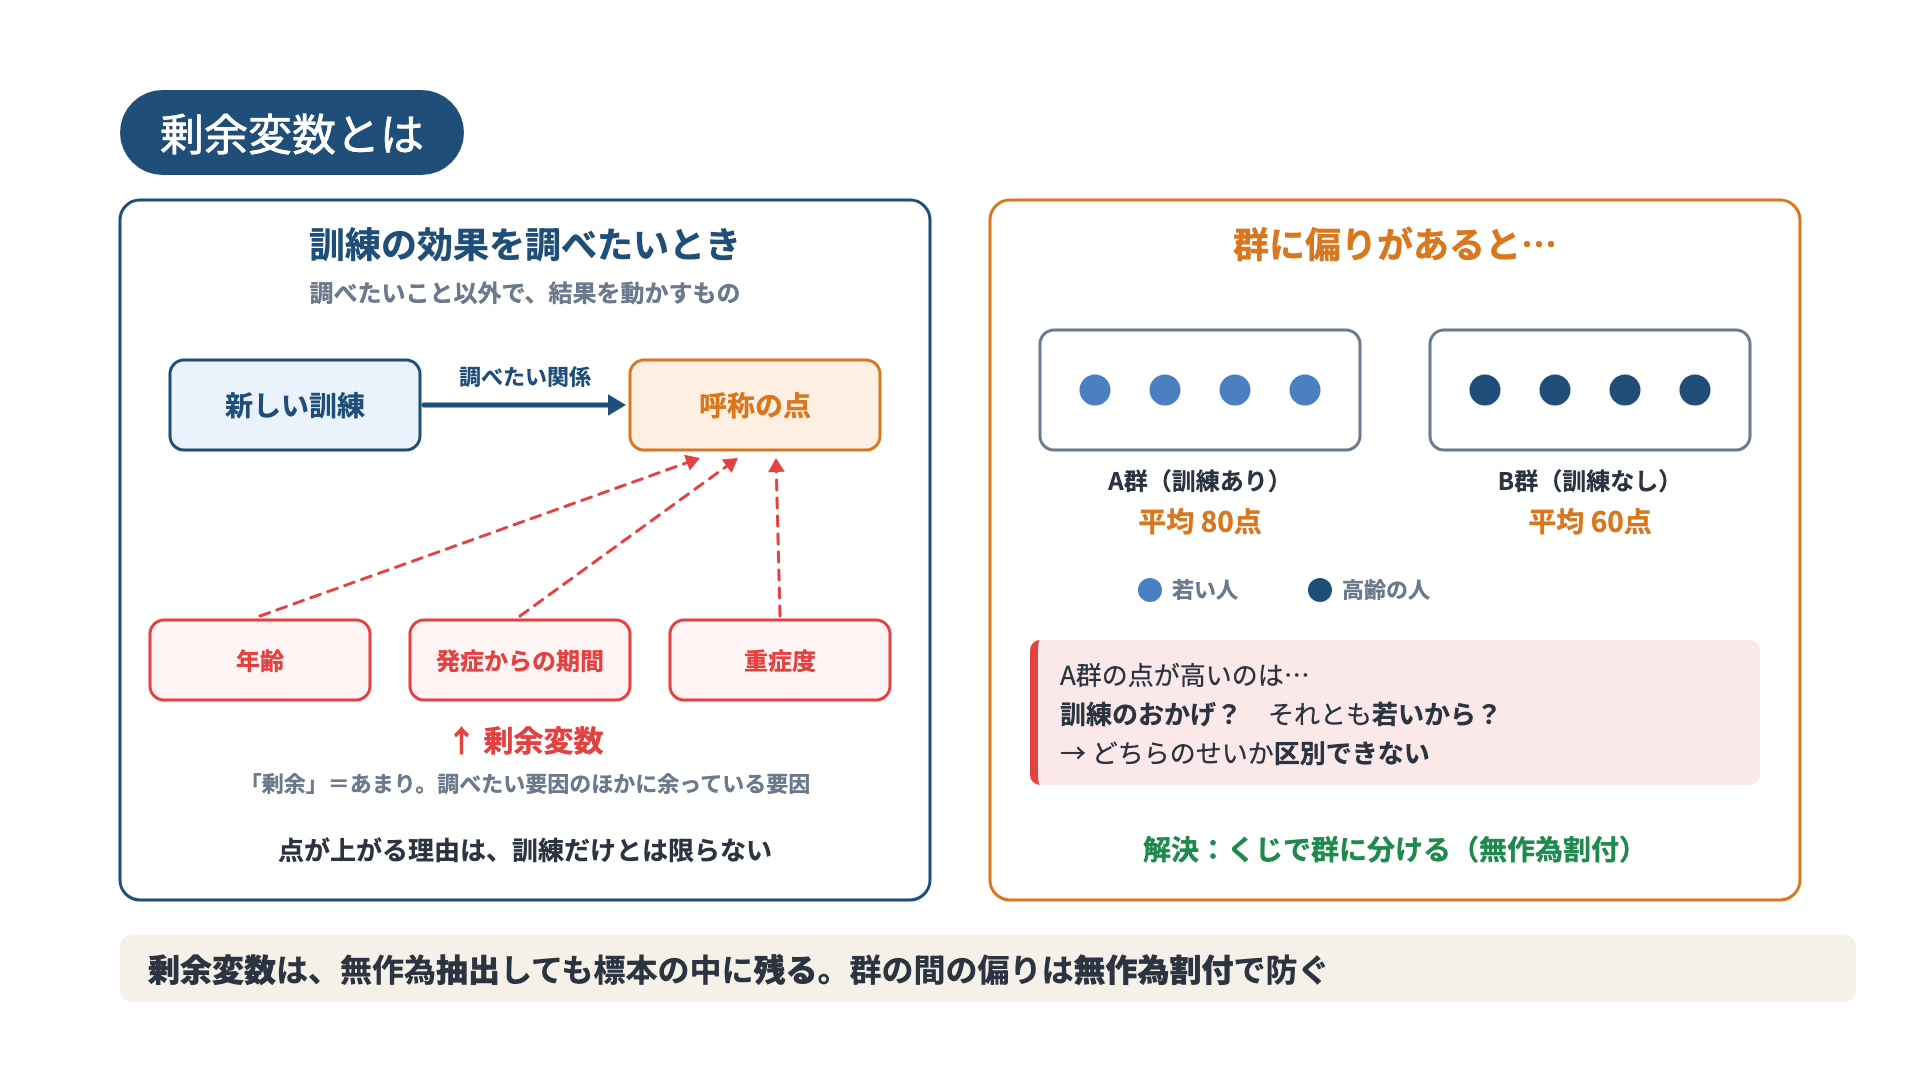
剰余変数は、調べたいこと以外で、結果を動かしてしまうものです。「新しい訓練で呼称の点が上がるか」を調べるとき、年齢・発症からの期間・重症度も点を動かします。訓練をした群に若い人ばかりが入ると、点が高くても、訓練のおかげか若いからか区別できません。
無作為抽出をしても、標本の中には若い人も高齢の人もそのまま残ります。剰余変数を消すことはできません。
抽出と割付はちがう
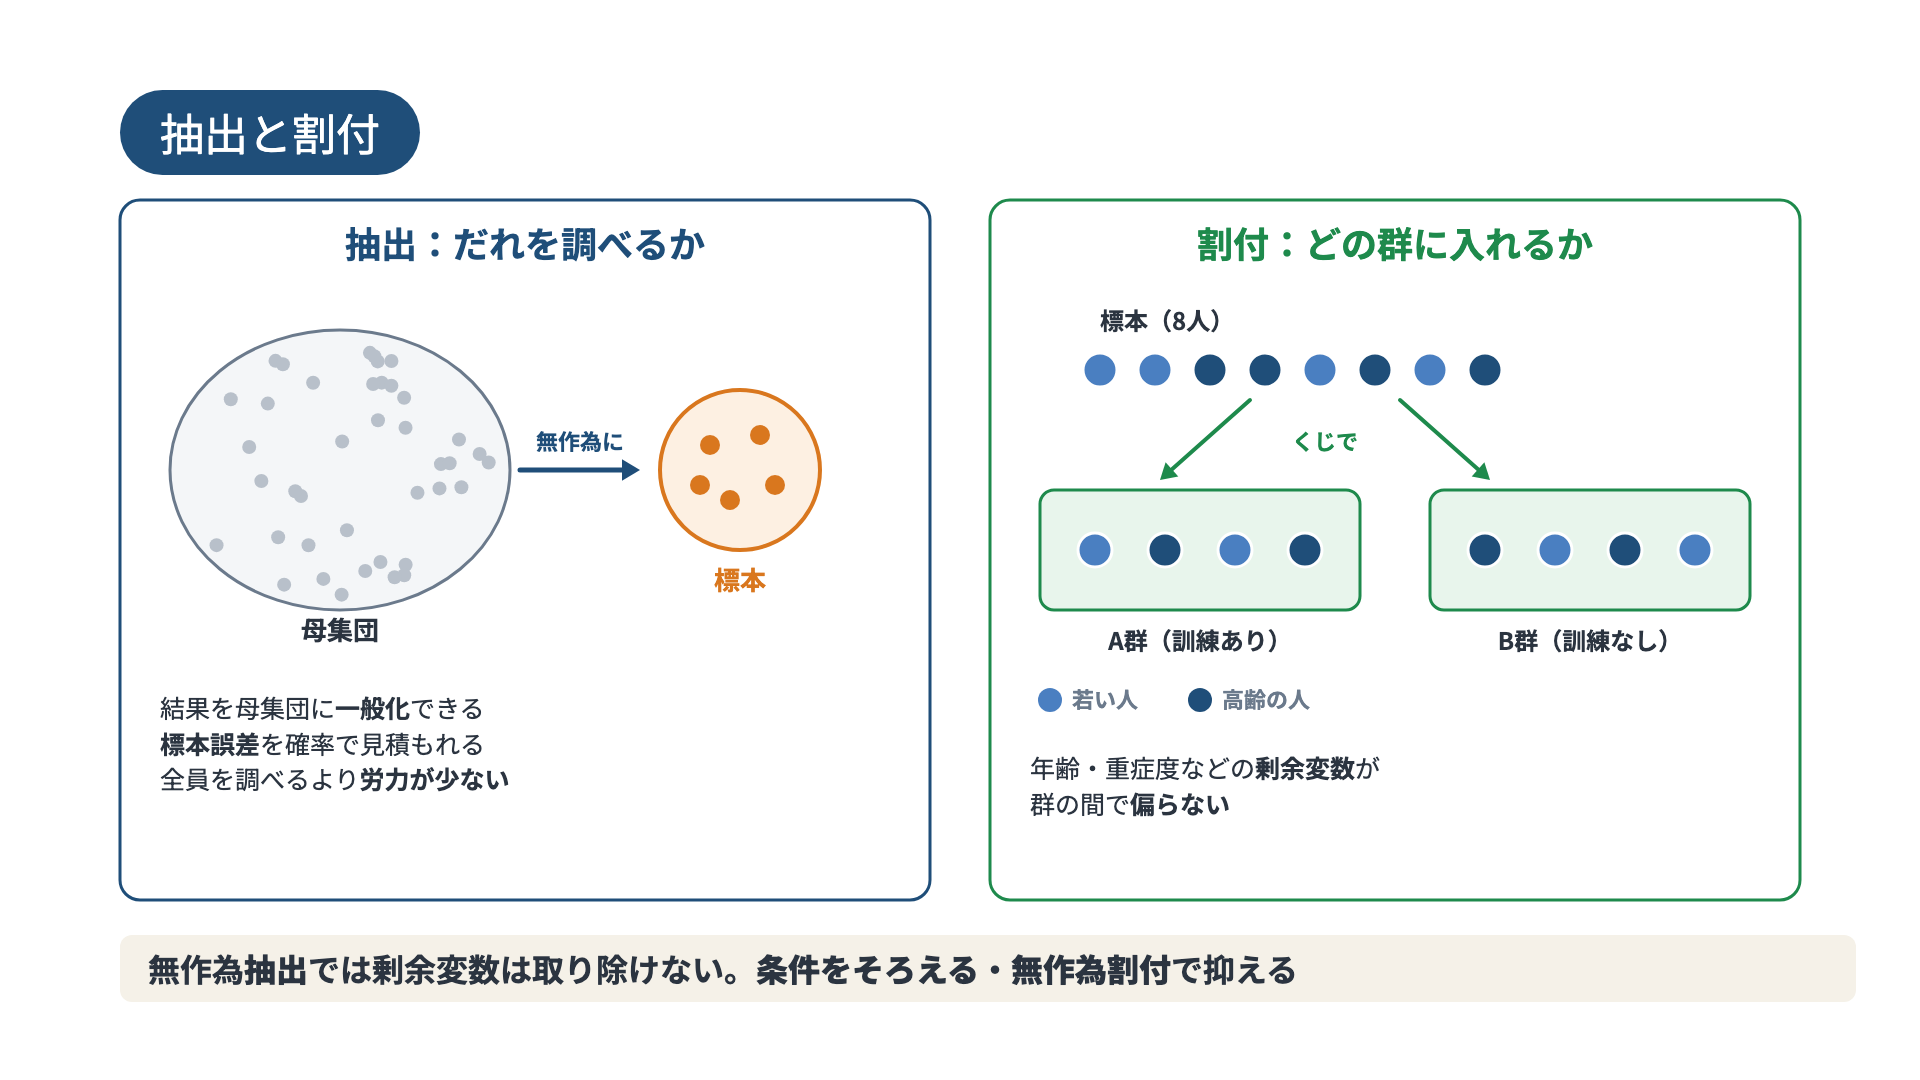
無作為抽出は、母集団からだれを調べるかを偶然で決めることです。無作為割付は、選んだ人をどの群に入れるかを偶然で決めることです。剰余変数の偏りを防ぐのは、割付のほうです。
選択肢ごとの解説
1.確率的な検討
〇 正しい
「確率的な検討」とは、「この結果は、偶然でも起こりそうか」を確率(何%くらい起こるか)で考えることです。
くじで選ぶと、だれが選ばれるかは偶然で決まります。偶然のしくみが分かっているので、「たまたまこの結果になる確率は何%か」を計算できます。無作為抽出で可能になります。
2.限られた標本から得られた結果の一般化
〇 正しい
「一般化」とは、調べた一部の人(標本)で分かったことを、調べていない人も含めた全員(母集団)にも当てはまる、と広げて考えることです。
例:全国の小学1年生から無作為に500人を選んで調べたら、構音の誤りがある子は8%だった。そこで「全国の1年生でも、だいたい8%だろう」と考える。これが一般化です。
もし、ことばの教室に通う子だけを選んでいたら、8%より多く出るはずで、全国には当てはめられません。無作為に選ぶと、標本が母集団のミニチュア(縮図)になるので、一般化できます。無作為抽出で可能になります。
3.剰余変数の影響の除去
× 誤り
剰余変数は、調べたいこと以外で、結果を動かしてしまうものです。「剰余」は「あまり」という意味で、調べたい要因のほかに余っている要因のことです。
例:「新しい訓練で、失語症の人の呼称の点が上がるか」を調べたいとします。点を上げるのは訓練だけではありません。年齢が若い、発症してから日が浅い(自然に回復しやすい時期)、もともと軽い――こうしたことでも点は上がります。これらが剰余変数です。
訓練をした人に若い人ばかりが集まると、点が上がっても、訓練のおかげか、若いからか、区別できません。これが剰余変数の影響です。
無作為抽出は「だれを調べるか」を偶然で決めるだけです。選ばれた人の中には、若い人も高齢の人も、軽い人も重い人も、そのまま混ざっています。年齢や重症度の影響が消えるわけではありません。無作為抽出では除去できないので、これが正答です。
剰余変数は、①条件をそろえる(例:発症から6か月以上たった人だけを対象にする)、②無作為に割り付ける(くじで訓練あり・なしの群に分け、若い人と高齢の人が両方の群に同じくらい入るようにする)、などで抑えます。
4.調査に要する労力の抑制
〇 正しい
全員を調べる全数調査は、人数が多いと時間もお金もかかります。標本調査なら、全国の1年生全員ではなく、例えば500人を調べれば済みます。無作為抽出で可能になります。
5.標本誤差の評価
〇 正しい
標本誤差は、標本の値と、母集団の本当の値とのずれです。500人で8%でも、全員を調べたら7.5%かもしれません。一部しか調べない以上、ずれは必ず出ます。
無作為に選んでいれば、ずれは偶然だけで生まれるので、「ずれはだいたい±2〜3%くらい」と確率で見積もれます。ここでの「評価」は、ずれの大きさを見積もるという意味です。無作為抽出で可能になります。
以上から、正答は3です。
言語聴覚士の臨床とつなげる
訓練の効果を調べる研究では、年齢や発症からの期間、重症度が結果に影響します。これらが剰余変数です。対象者をどの訓練に入れるかをくじで決める(無作為割付)と、2つの群で年齢や重症度が偏りにくくなります。論文を読むときは、「抽出」と「割付」のどちらが無作為なのかを確かめます。
覚え方
抽出=だれを調べるか → 一般化・標本誤差。
割付=どの群に入れるか → 剰余変数の偏りを防ぐ。
確認問題(一問一答)
Q1. 結果に影響してしまう、調べたい要因以外の要因は?
答えを見る
剰余変数。
Q2. 標本の値と母集団の本当の値とのずれは?
答えを見る
標本誤差。
Q3. 無作為抽出で剰余変数の影響は除ける?
答えを見る
除けない。
Q4. 剰余変数の偏りを群の間で防ぐ方法は?
答えを見る
無作為割付。
Q5. 全員を調べる調査は?
答えを見る
全数調査。
まとめ
- 無作為抽出で、確率的な検討・一般化・労力の抑制・標本誤差の評価ができる。
- 剰余変数の影響は、条件をそろえる・無作為割付で抑える。
- 正答は3。
次に復習すること
- 4つの抽出法
- 標本調査と全数調査
- 標本の大きさ
出典
問題文:第26回 言語聴覚士国家試験 午後 第27問