第25回 言語聴覚士国家試験 午後 第28問 | 分野:心理測定法
多変量解析、因子分析、パス解析。統計の用語は、名前だけ見ても意味が想像しにくいものばかりです。この記事では、数式を使わず、テストの点を例に、1つずつイラストで説明します。
問題
用語の例または説明として誤っている組合せはどれか。
- a.質的データ ― 名義尺度の水準の測定値
- b.縦断的データ ― さまざまな年齢群の人々を一斉に測定して得られる測定値
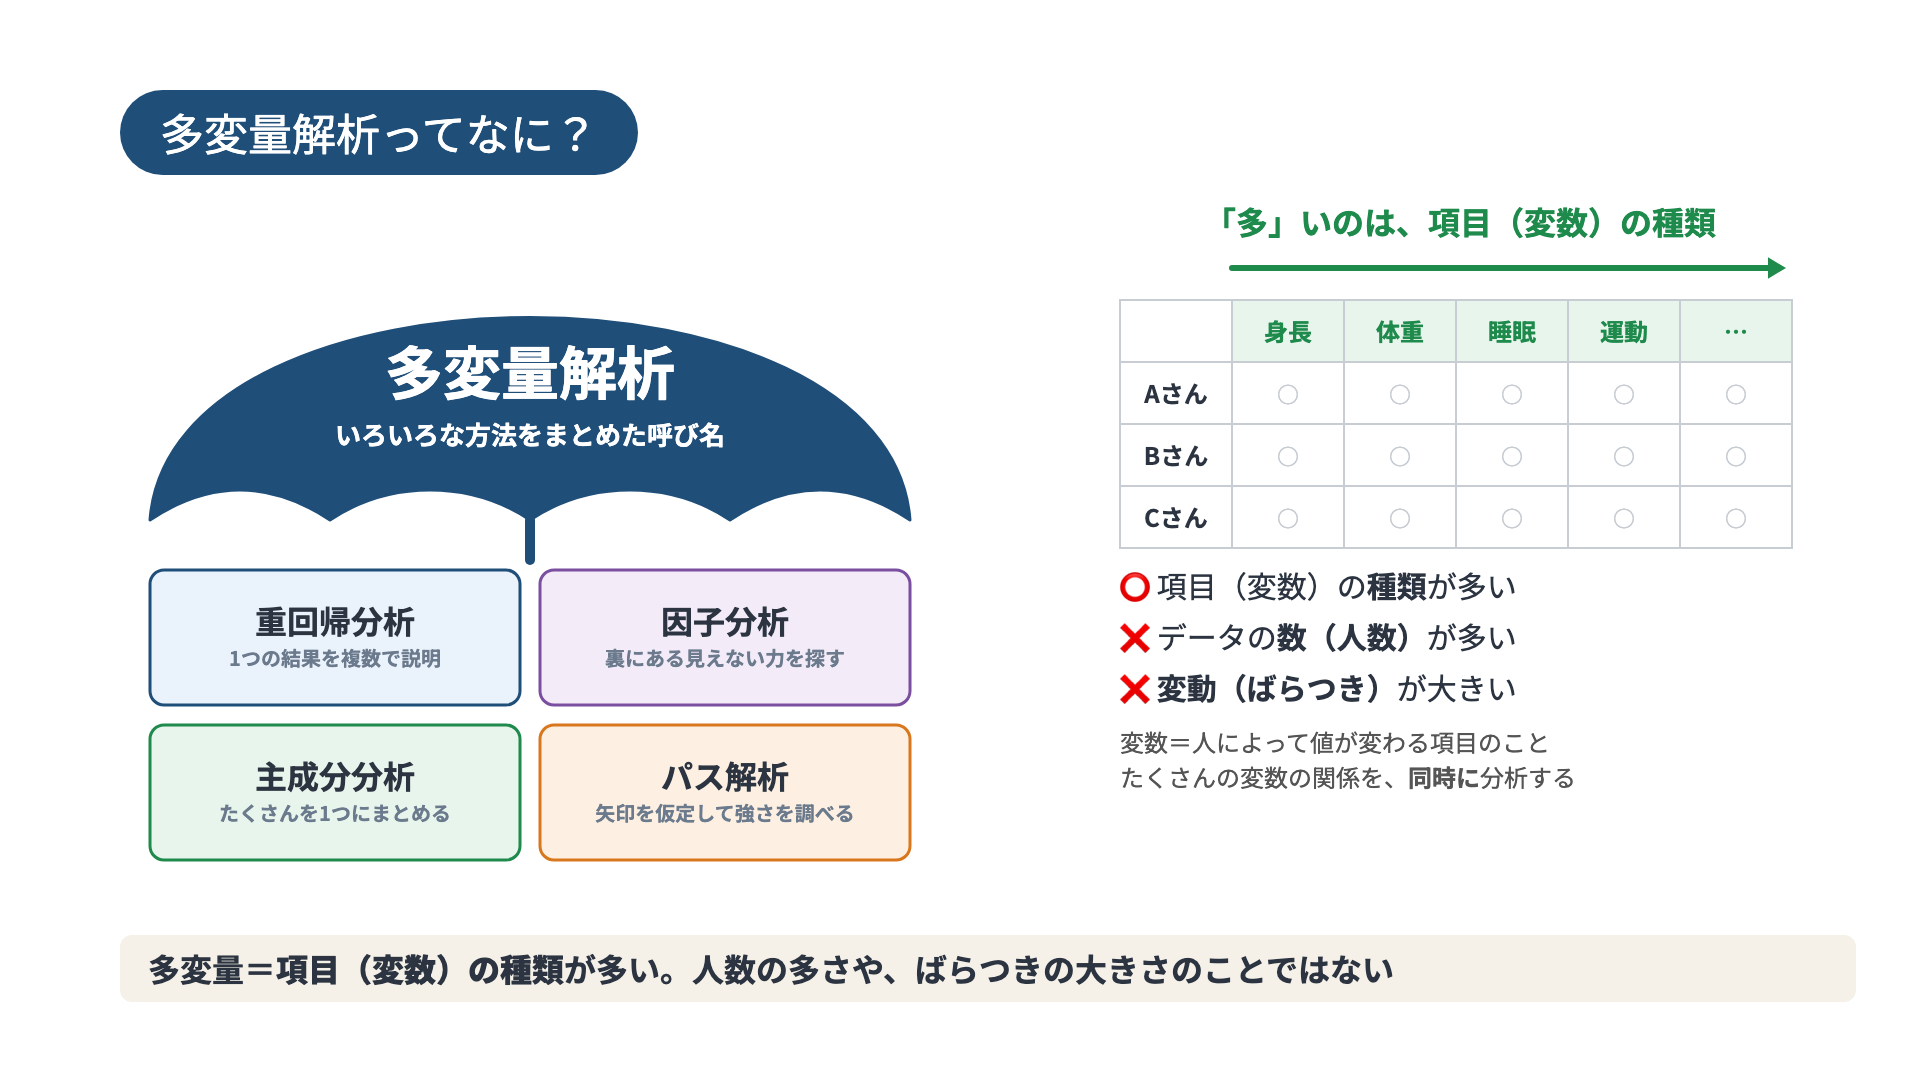
- c.多変量解析 ― データ数が巨大な場合に用いられる分析
- d.パス解析 ― 因果関係を仮定した分析
- e.分散分析 ― 平均値の差の検定
1. a,b 2. a,e 3. b,c 4. c,d 5. d,e
まずは自分で答えを選んでから、下のボタンを押して正答を確かめてください。
▶ ここを押して正答を見る
正答:3(縦断的データは同じ人を追って測るもの、多変量解析は項目の種類が多いときの分析)
この問題で問われていること
統計の用語の意味が問われています。
この問題で間違えやすい理由
① 横断と縦断が入れかえてある。
② 多変量解析の「多」を、データの数が多いことと勘違いしやすい。
まずは基本:多変量解析ってなに?
重回帰分析:1つの結果を、複数の原因で説明する
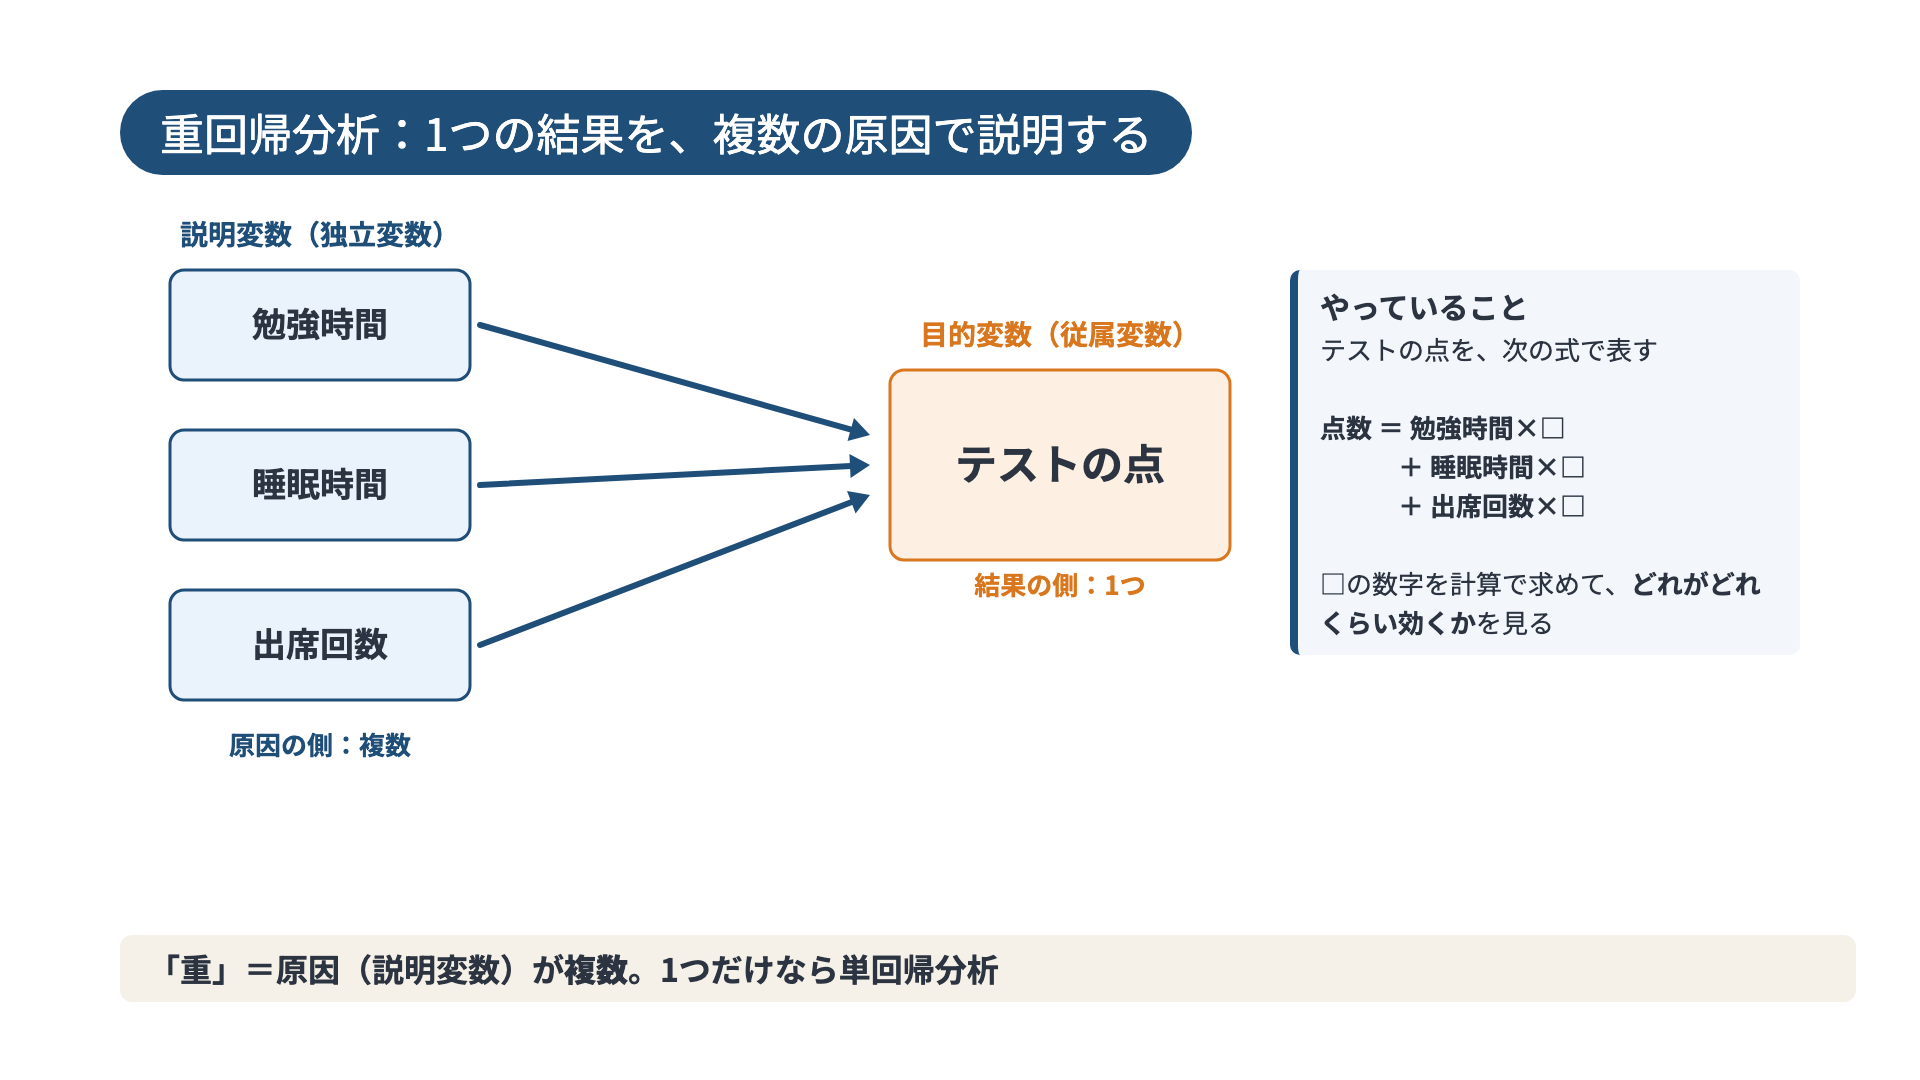
テストの点は、勉強時間だけで決まるわけではありません。睡眠や出席も関係しそうです。そこで、1つの結果(目的変数)を複数の原因(説明変数)で表す式を作ります。これが重回帰分析です。
独立変数=説明変数、従属変数=目的変数で、同じ意味です。「従属」は「ほかの変数に左右される側」と読むと覚えやすいです。
因子分析:点数の裏にある、見えない力を探す
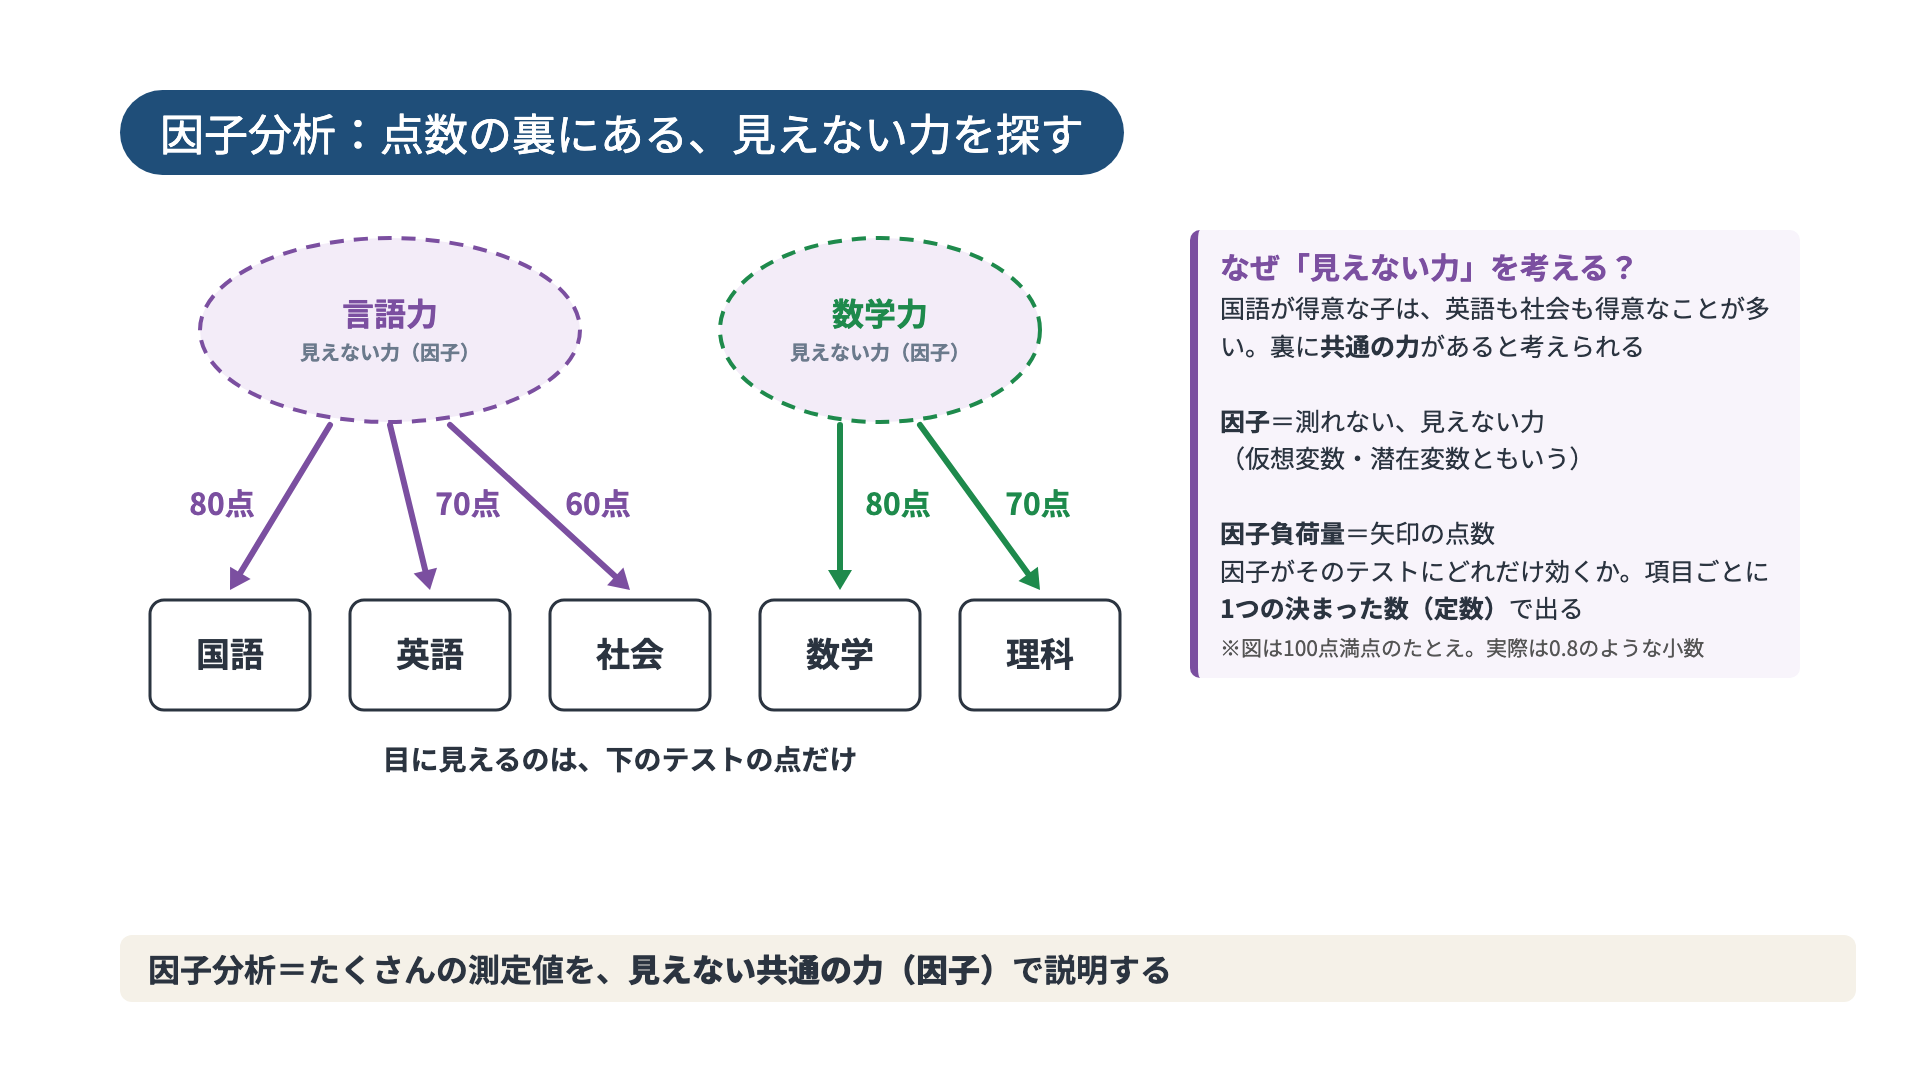
国語が得意な子は、英語も社会も得意なことが多いです。これは、3教科の裏に「言語力」という共通の力があるからだ、と考えられます。「言語力」は直接は測れません。測れるのは、テストの点だけです。
このように、測れる点数のつながり(相関)から、見えない共通の力(因子)を見つけ出すのが因子分析です。見えない力なので、仮想変数や潜在変数とも呼びます。
矢印の点数が因子負荷量です。因子がそのテストにどれだけ効いているかを表します。図では分かりやすく100点満点にしました。国語に80点なら「言語力が強く効いている」、社会に60点なら「それよりは弱い」と読みます。実際の分析では、80点は0.8のような小数で出てきます。人によって変わる数字ではなく、国語なら80点のように、項目ごとに1つの決まった数として計算されます。これが「定数として算出される」の意味です。
主成分分析:たくさんの項目を、1つの点にまとめる
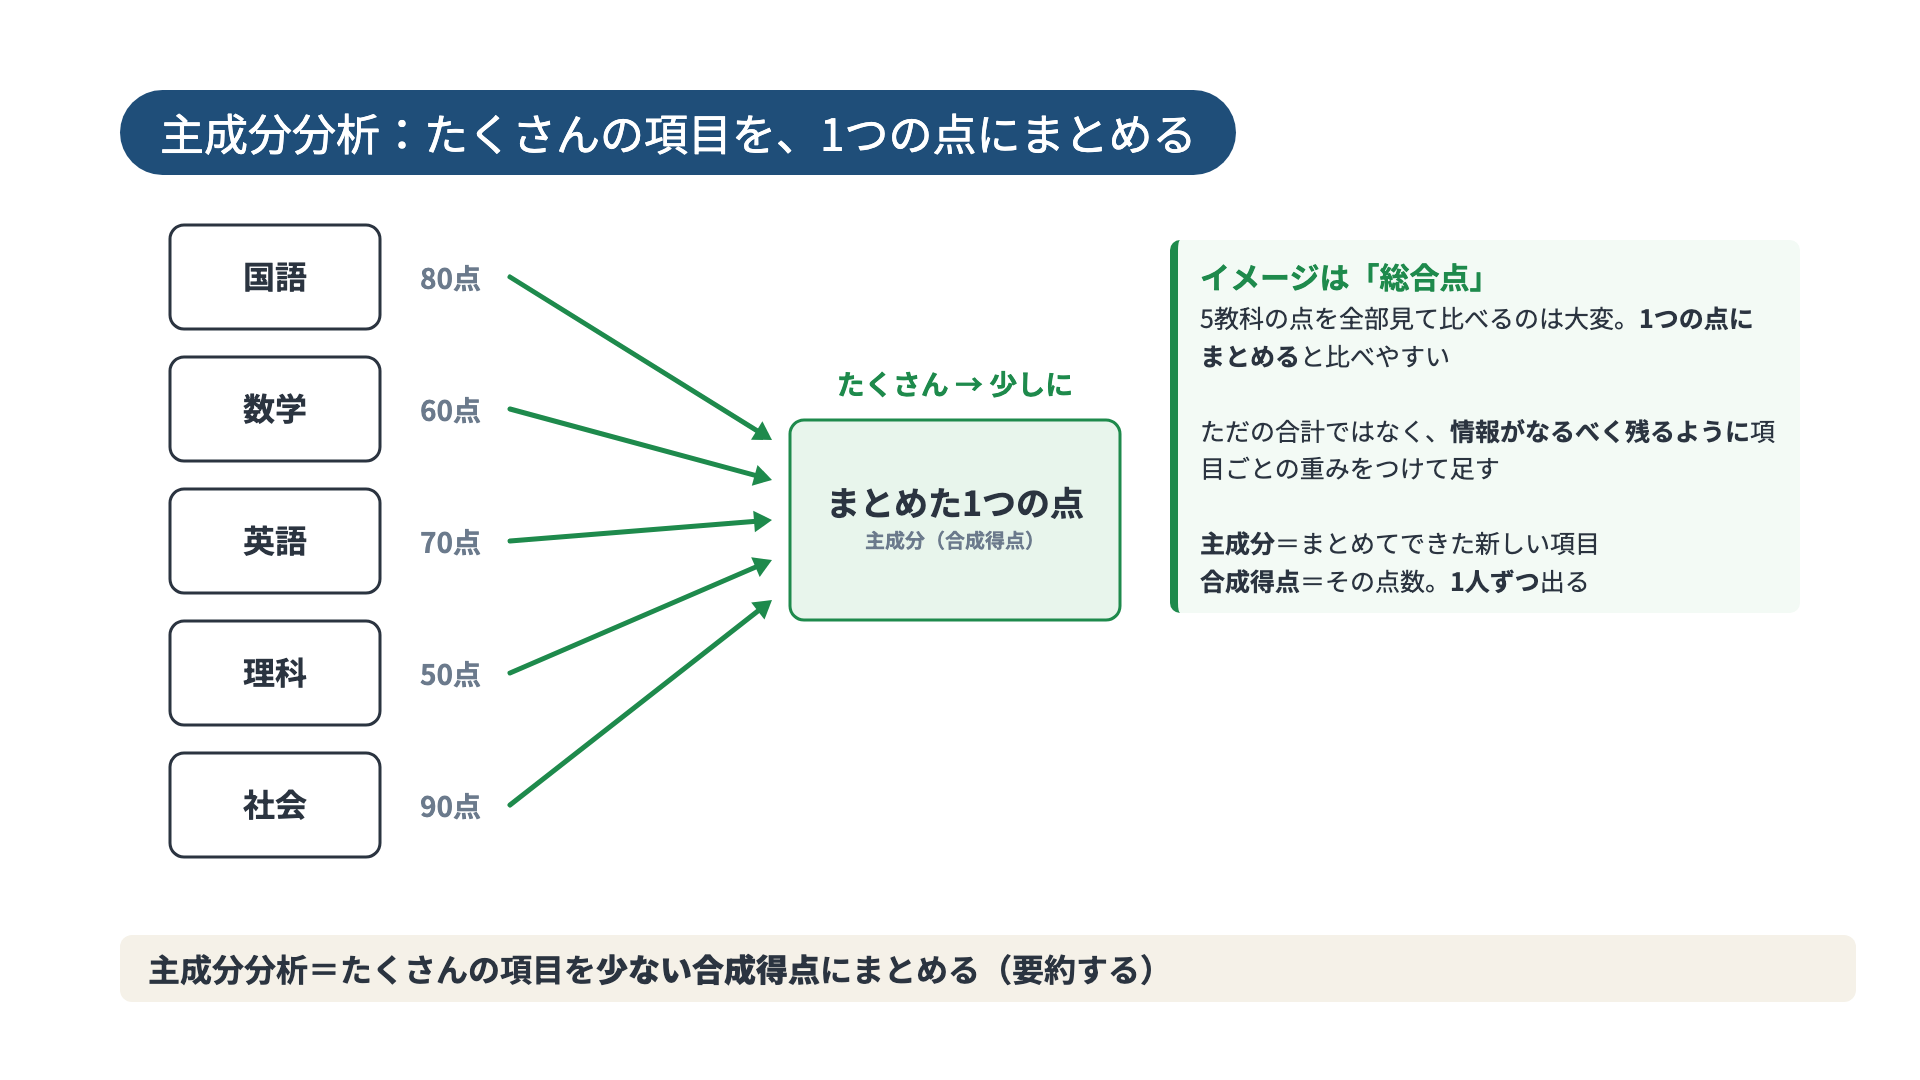
5教科の点を全部ならべて比べるのは大変です。そこで、なるべく情報を残したまま、少ない点数にまとめます。これが主成分分析です。イメージは「総合点」です。まとめてできた点数を合成得点(主成分得点)といい、1人ずつ計算されます。
因子分析と主成分分析の違い
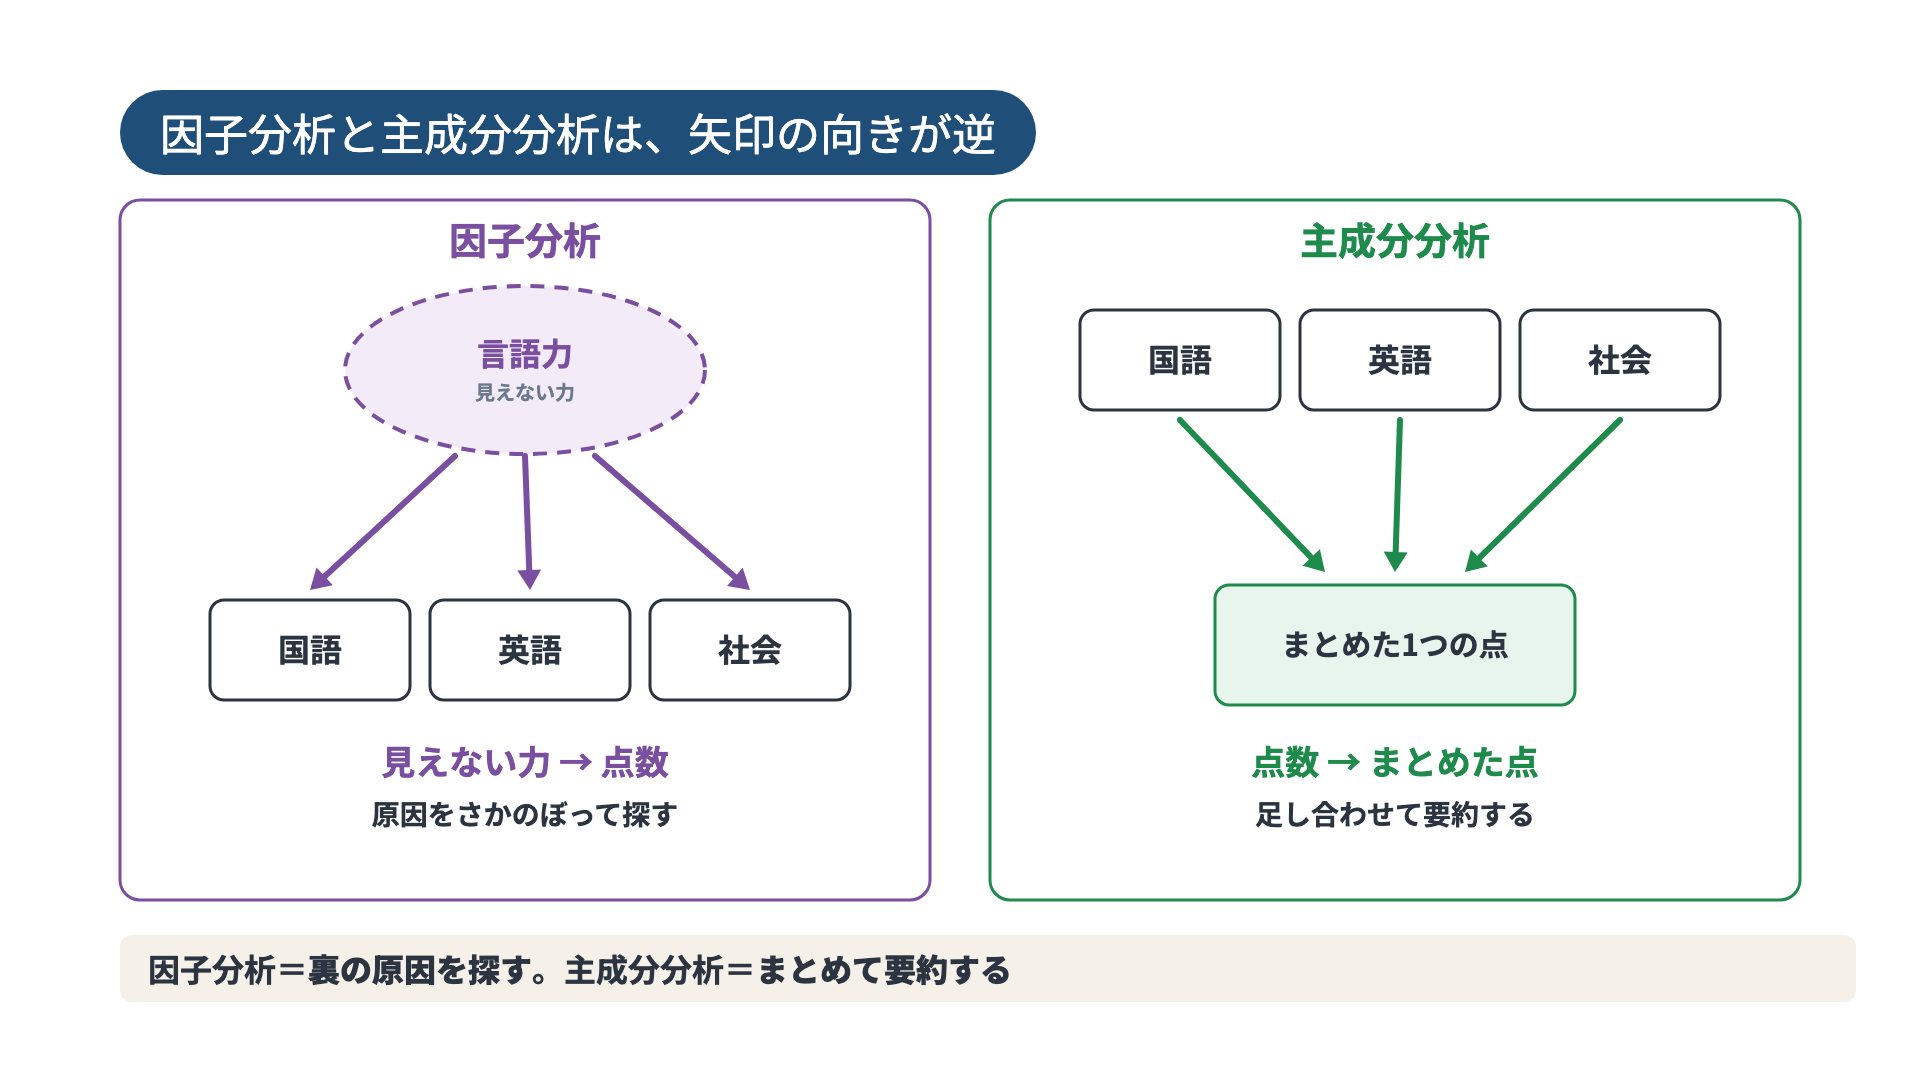
2つはよく似て見えますが、矢印の向きが逆です。因子分析は「見えない力が点数を生んでいる」と考えて原因をさかのぼります。主成分分析は「点数を足し合わせて」要約します。
パス解析:先に矢印を決めて、強さを調べる
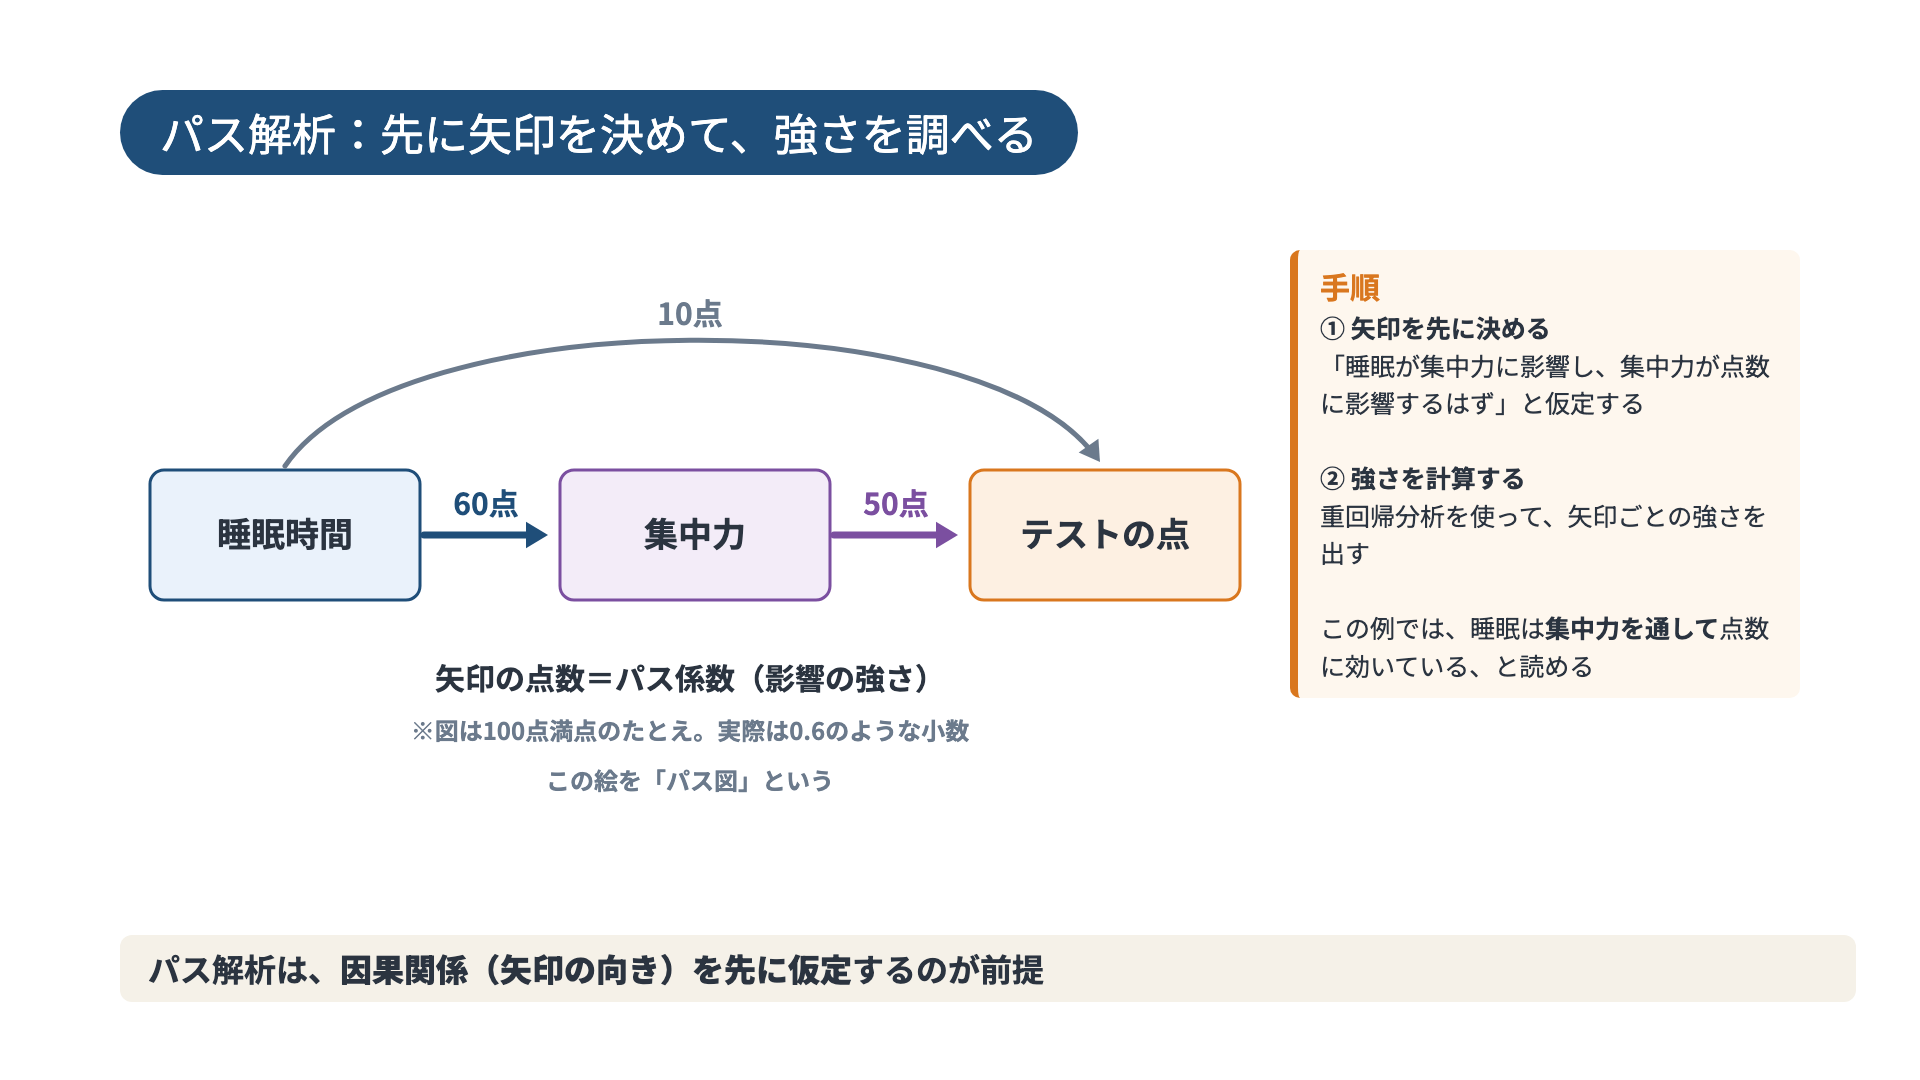
パス解析では、まず「睡眠が集中力に影響し、集中力が点数に影響するはず」と、原因と結果の向き(因果関係)を先に仮定して、矢印の図を描きます。そのうえで、矢印ごとの強さ(パス係数)を計算します。図では分かりやすく100点満点にしました。実際の分析では、60点は0.6のような小数で出てきます。
大切なのは、矢印の向きは計算で決まるのではなく、分析する人が先に決めることです。だから「因果関係の前提が必要」といわれます。
縦断的データと横断的データ
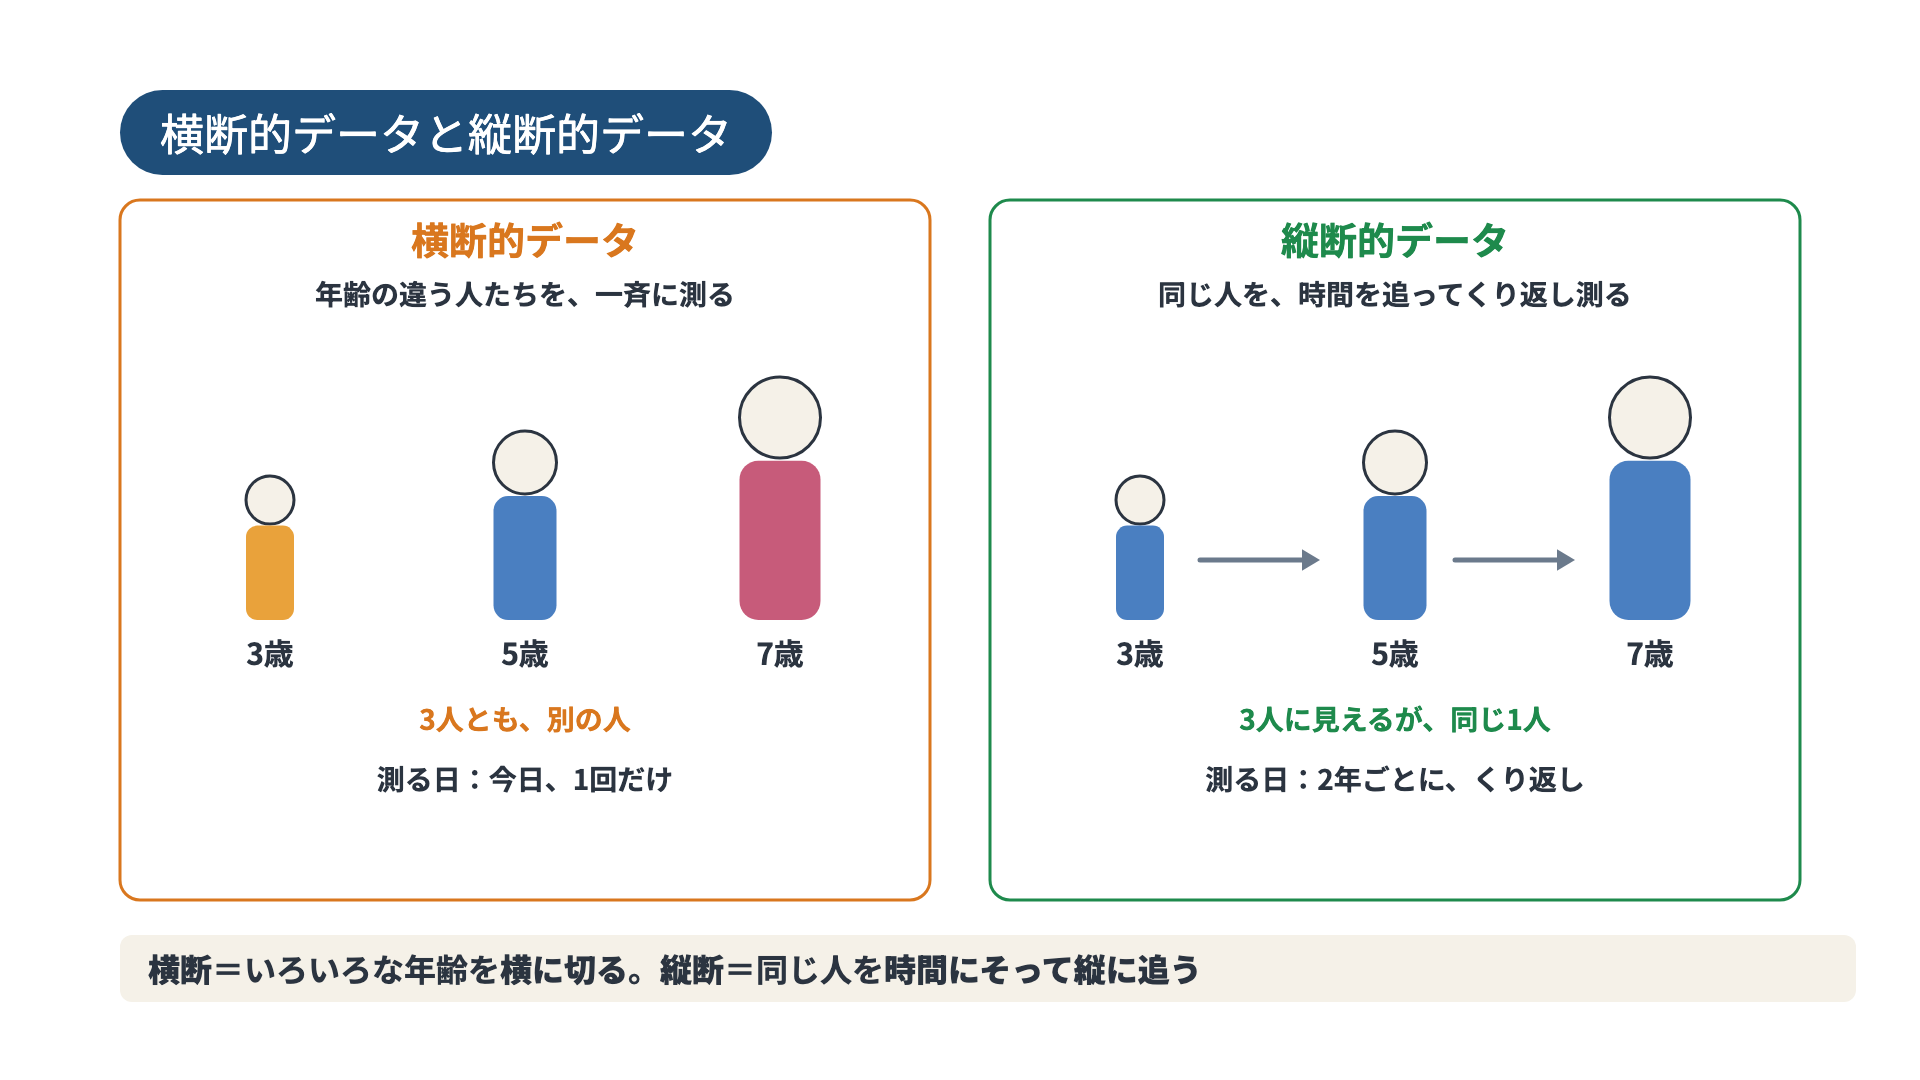
「断」は切ることです。横断は、ある1日を横に切って、いろいろな年齢の人を一斉に測ります。縦断は、同じ人を時間にそって縦に追います。横断は1回で済みますが、同じ人の変化は分かりません。縦断は変化が分かりますが、長い時間がかかります。
質的データと量的データ
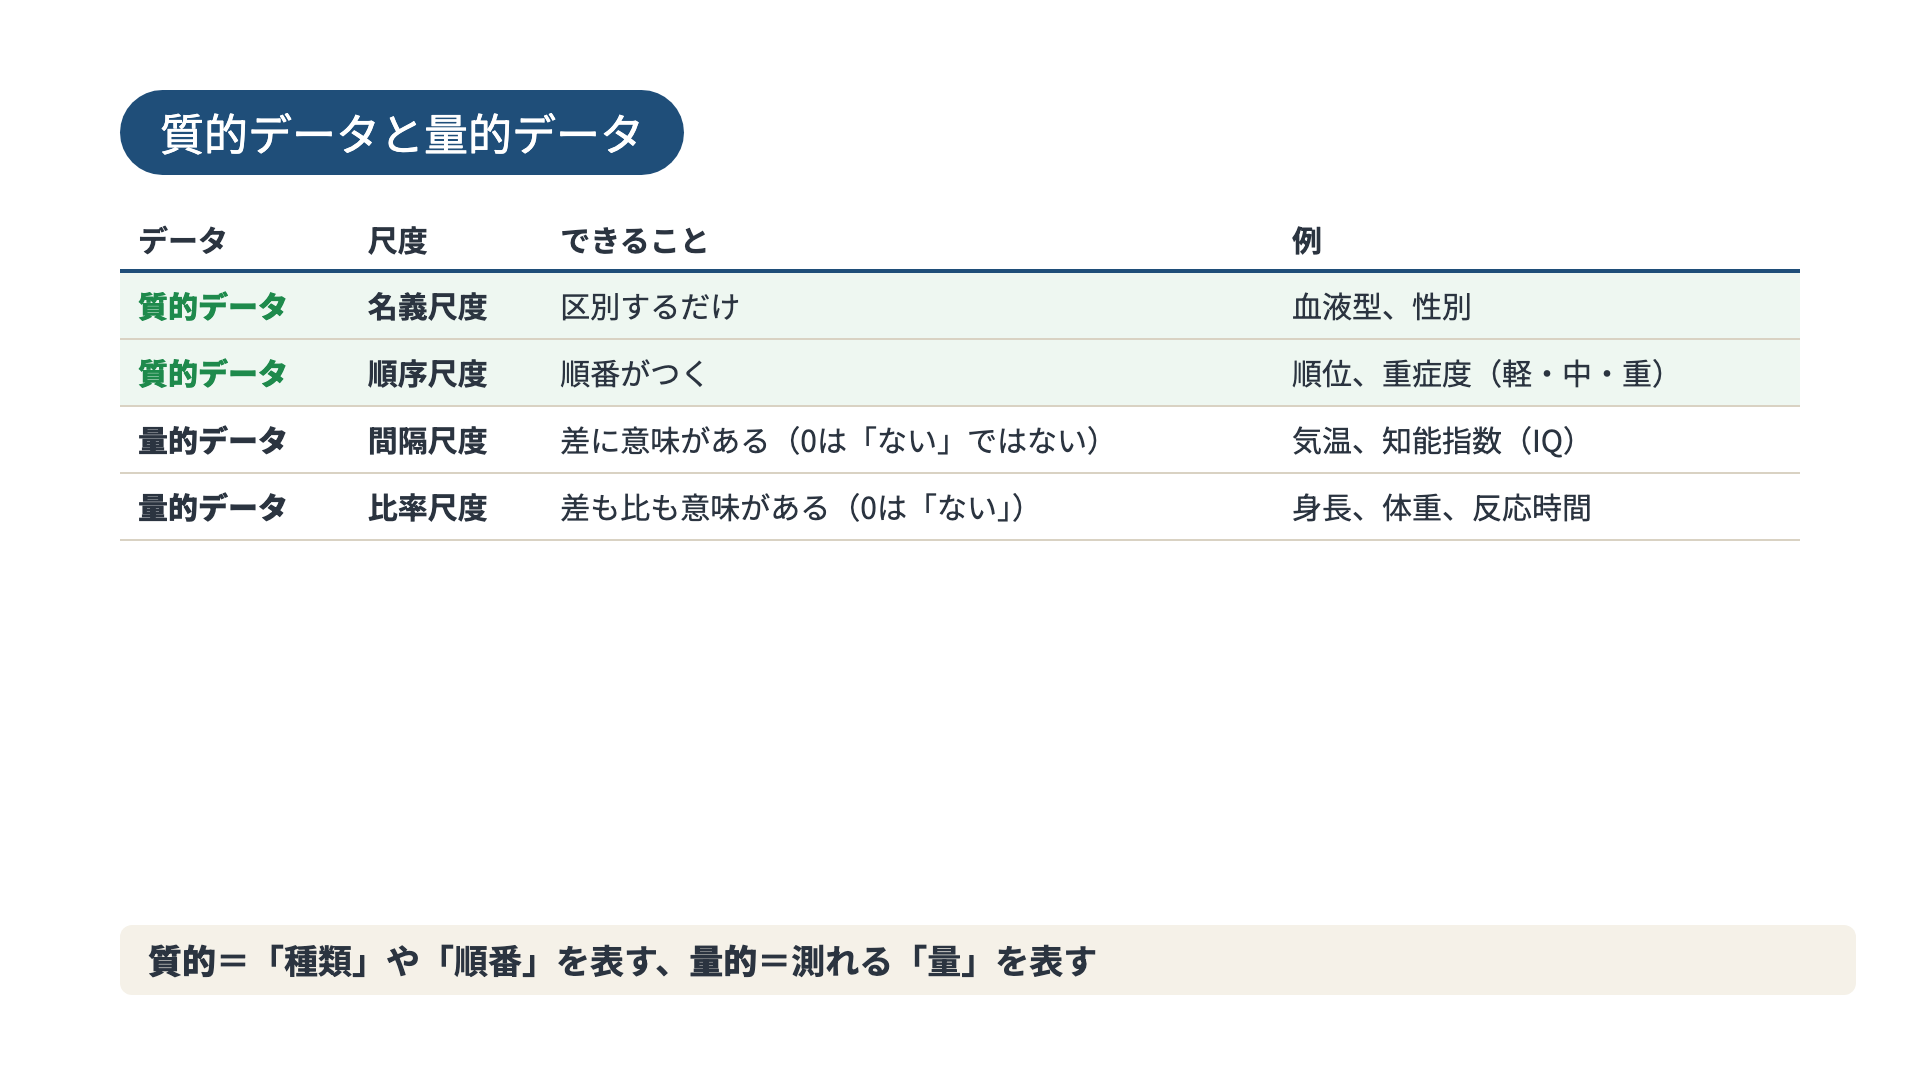
血液型のA型とB型は、足したり平均したりできません。このように種類を表すデータが質的データです。身長のように量を測れるデータが量的データです。
a〜eを1つずつ確かめる
a.質的データ ― 名義尺度の水準の測定値
× 誤り
血液型のように、種類を区別するだけのデータは質的データです。名義尺度はこれにあたるので、正しい組合せです。
b.縦断的データ ― さまざまな年齢群の人々を一斉に測定して得られる測定値
〇 正しい
これは横断的データの説明です。誤っているので、選びます。
縦断的データは、同じ人を時間を追ってくり返し測るデータです。年齢の違う人を一斉に測ると、1回で済みますが、変化を追ったことにはなりません。
c.多変量解析 ― データ数が巨大な場合に用いられる分析
〇 正しい
多いのはデータの数ではなく、項目(変数)の種類です。誤っているので、選びます。
人数が少なくても、身長・体重・睡眠などの項目を同時に分析すれば、多変量解析です。
d.パス解析 ― 因果関係を仮定した分析
× 誤り
パス解析は、原因と結果の向きを先に仮定して矢印の図を描き、強さを調べます。正しい組合せです。
e.分散分析 ― 平均値の差の検定
× 誤り
分散分析は、3群以上の平均値の差を調べる検定です。名前は「分散」ですが、調べるのは平均です。正しい組合せです。
誤っているのはbとcなので、正答は3です。
言語聴覚士の臨床とつなげる
言語聴覚士が検査の論文を読むときにも、これらの言葉が出てきます。例えば、言語検査の下位項目を因子分析して「この検査は2つの力を測っている」と示したり、発達の研究で縦断的データを使って同じ子どもの変化を追ったりします。
覚え方
横断=一斉に1回、縦断=同じ人を追う。
多変量の「多」は項目の種類。人数ではない。
確認問題(一問一答)
Q1. 年齢の違う人を一斉に測るデータは?
答えを見る
横断的データ。
Q2. 同じ人を時間を追って測るデータは?
答えを見る
縦断的データ。
Q3. 多変量解析の「多」は何が多い?
答えを見る
項目(変数)の種類。
Q4. 名義尺度は質的データ?量的データ?
答えを見る
質的データ。
Q5. パス解析の前提は?
答えを見る
因果関係を仮定すること。
まとめ
- b:一斉に測るのは横断的データ。
- c:多変量解析の「多」は項目の種類。
- 正答は3(b,c)。
次に復習すること
- 尺度の4つの水準
- 検定の使い分け
- 発達研究の方法
出典
問題文:第25回 言語聴覚士国家試験 午後 第28問